
Projekte, an denen ich gemessen werden will
In Transformationsprogrammen werden Daten oft zu spät eingeplant und mit zu wenig Budget ausgestattet. Die Folge sind Nacharbeit kurz vor dem Go-live, verschobene Termine und Daten, denen niemand traut.
Vier Projekte zeigen, wie es anders geht.

ÜBERBLICK
Vier Projekte, ein Muster
Jedes Mal am laufenden Vorhaben, mit klar verteilten Rollen und mit Ergebnissen, die über den Go-live hinaus Bestand haben.
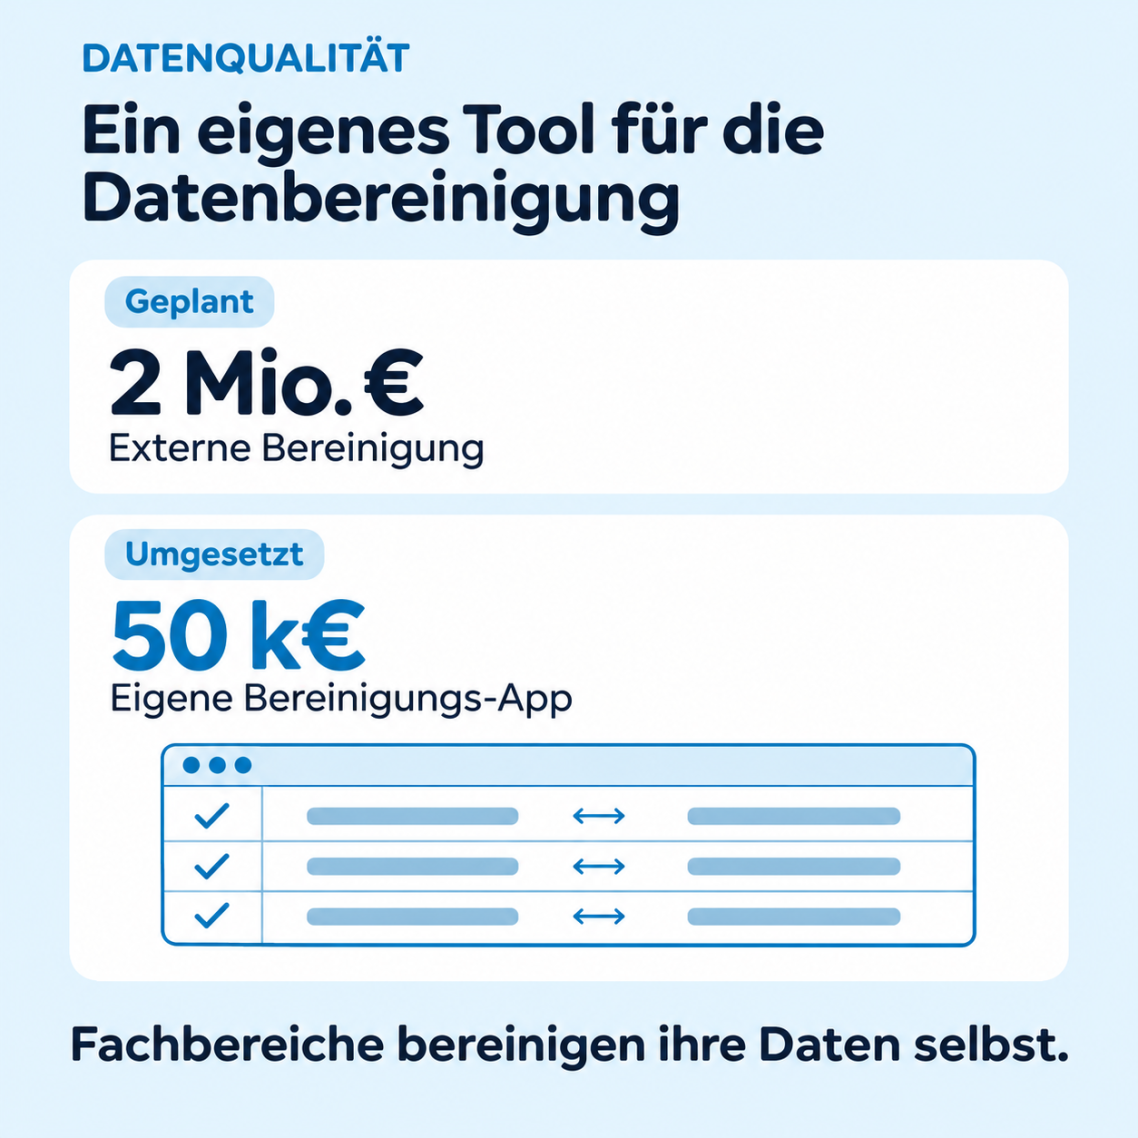
50 k€
Tatsächliche Kosten bei 2 Mio. € Planbudget. Die Fachbereiche bereinigen selbst, das Wissen bleibt im Unternehmen.
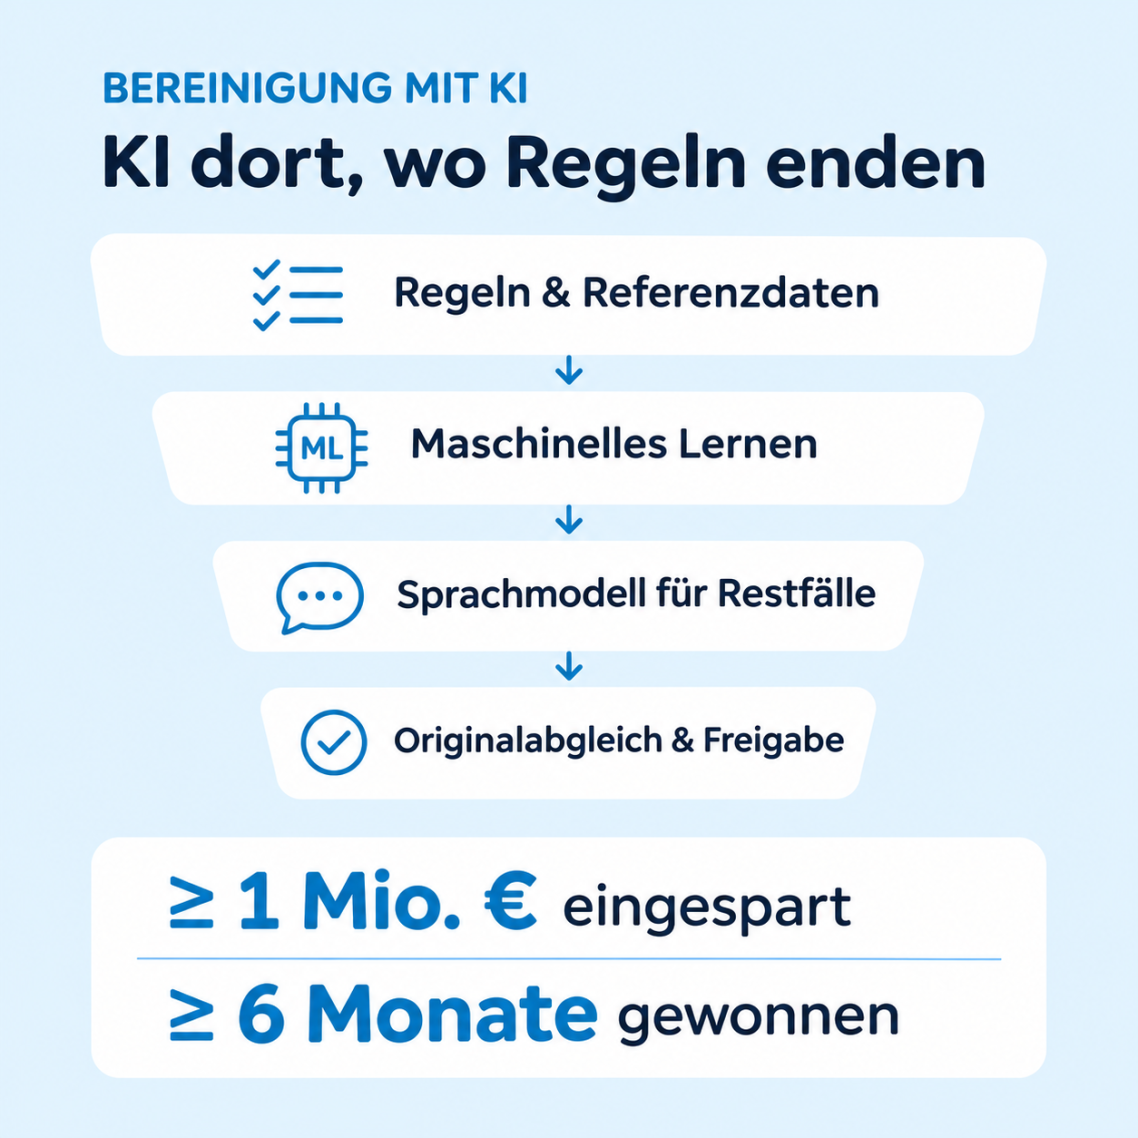
1 Mio. €
Mindestens so viel eingespart und mindestens sechs Monate gewonnen, ohne externe Dienstleister.
17 + 8
Business Data Stewards und Data Owner, in drei Ebenen bis zum Steering Committee.
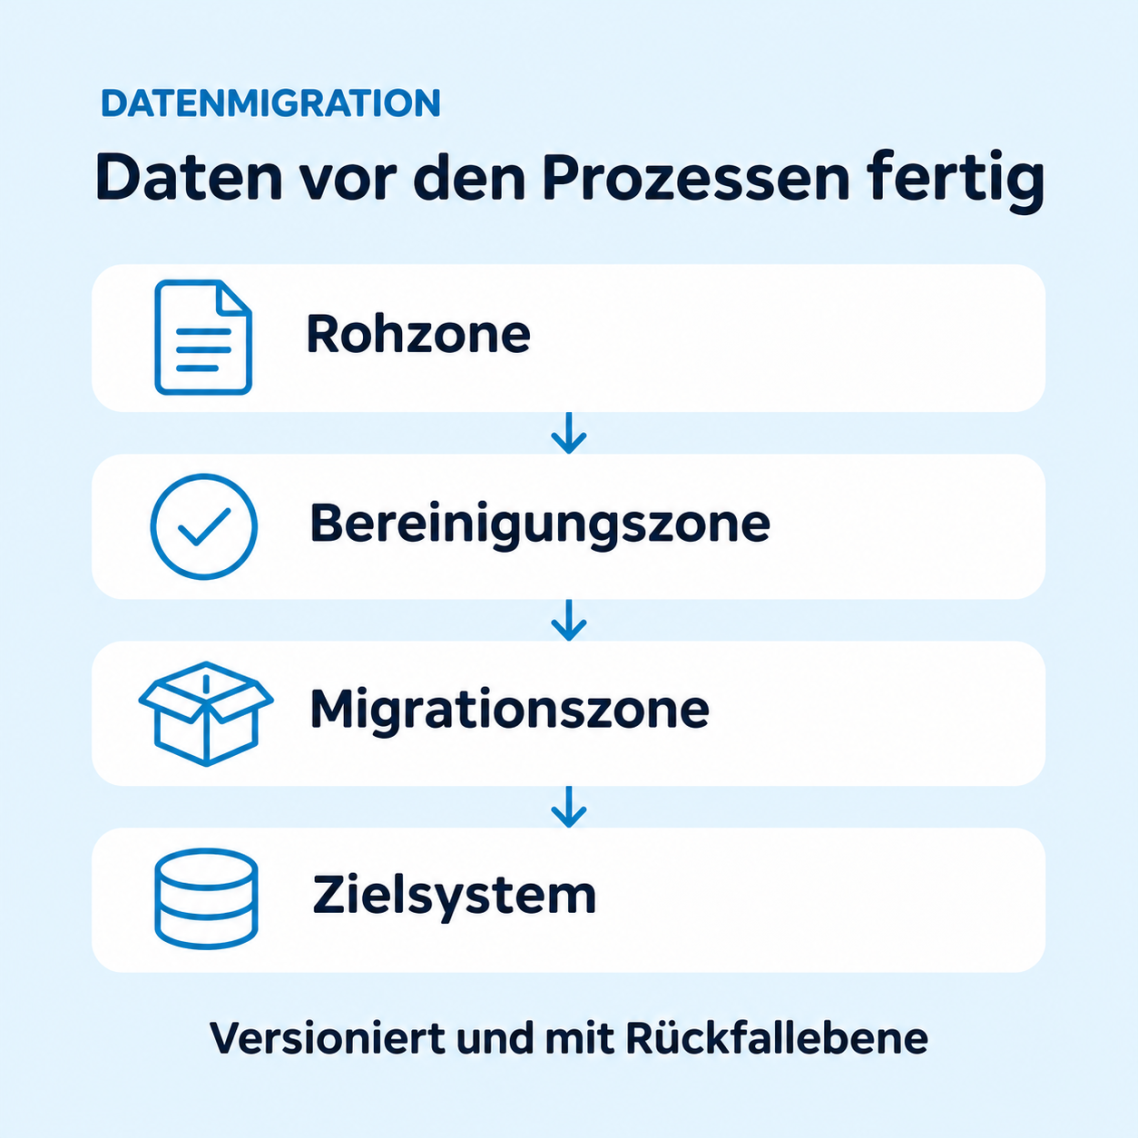
3 Zonen
Roh-, Bereinigungs- und Migrationszone: versioniert, mit Rückfallebene und klarer Verantwortung je Rolle.
PROJEKT 1 · DATENQUALITÄT
Eigenes Tool statt Beraterbudget
Ausgangslage
Internationaler Maschinenbaukonzern, Migration der Kunden- und Lieferantendaten nach SAP MDG.
Vor der Migration mussten die Stammdaten konzernweit bereinigt werden. Geplant war eine externe Bereinigung mit einem Budget von 2 Mio. €: einmalig, teuer, und ohne dass die Fachbereiche danach die Regeln kennen.
Ansatz
Ich habe eine schlanke Web-Anwendung entwickelt, mit der die Fachbereiche selbst bereinigen: Regeln und Adressprüfung zuerst, Prüfung der USt-ID, Dublettenerkennung mit maschinellem Lernen. Wer bereinigt, sieht sofort, warum ein Datensatz auffällt. So bleibt das Wissen im Unternehmen.
Ergebnis: Planbudget 2 Mio. €, tatsächliche Kosten rund 50 k€. Die Dublettenanalyse dauerte einen Tag statt eines Monats.
PROJEKT 2 · BEREINIGUNG MIT KI
KI dort, wo Regeln enden
Ausgangslage
Internationale Unternehmensgruppe, professionelle Dienstleistungen, SAP-Migration 2025–2026.
Mehrere Millionen Geschäftspartner-Datensätze aus vielen Gesellschaften mussten vor der Migration bereinigt werden: Dubletten, Konzernzuordnung, unvollständige Adressen. Die übliche Antwort wäre ein externer Dienstleister gewesen, mit monatelanger Laufzeit.
Ansatz
Eine eigene Anwendung in vier Stufen: zuerst Regeln und Referenzdaten (präzise, günstig, nachvollziehbar), dann maschinelles Lernen für Dubletten und Konzernzuordnung, ein Sprachmodell nur für den Restbestand, jedes Ergebnis gegen das Original geprüft. Übernommen wird nur nach fachlicher Freigabe.
Ergebnis: Mindestens 1 Mio. € eingespart und mindestens 6 Monate gewonnen, ohne externe Dienstleister und mit weniger internen Ressourcen.
PROJEKT 3 · DATA GOVERNANCE
Governance im Konzern verankert
Ausgangslage
Internationaler Industriekonzern, S/4-Transformation. Meine Rolle: Head of Data Governance und Global Process Owner Stammdaten.
Es hatte bereits mehrere erfolglose Anläufe zu Data Governance gegeben. Für die laufende S/4-Transformation fehlten Standards, Verantwortliche und das Vertrauen in die Daten.
Ansatz
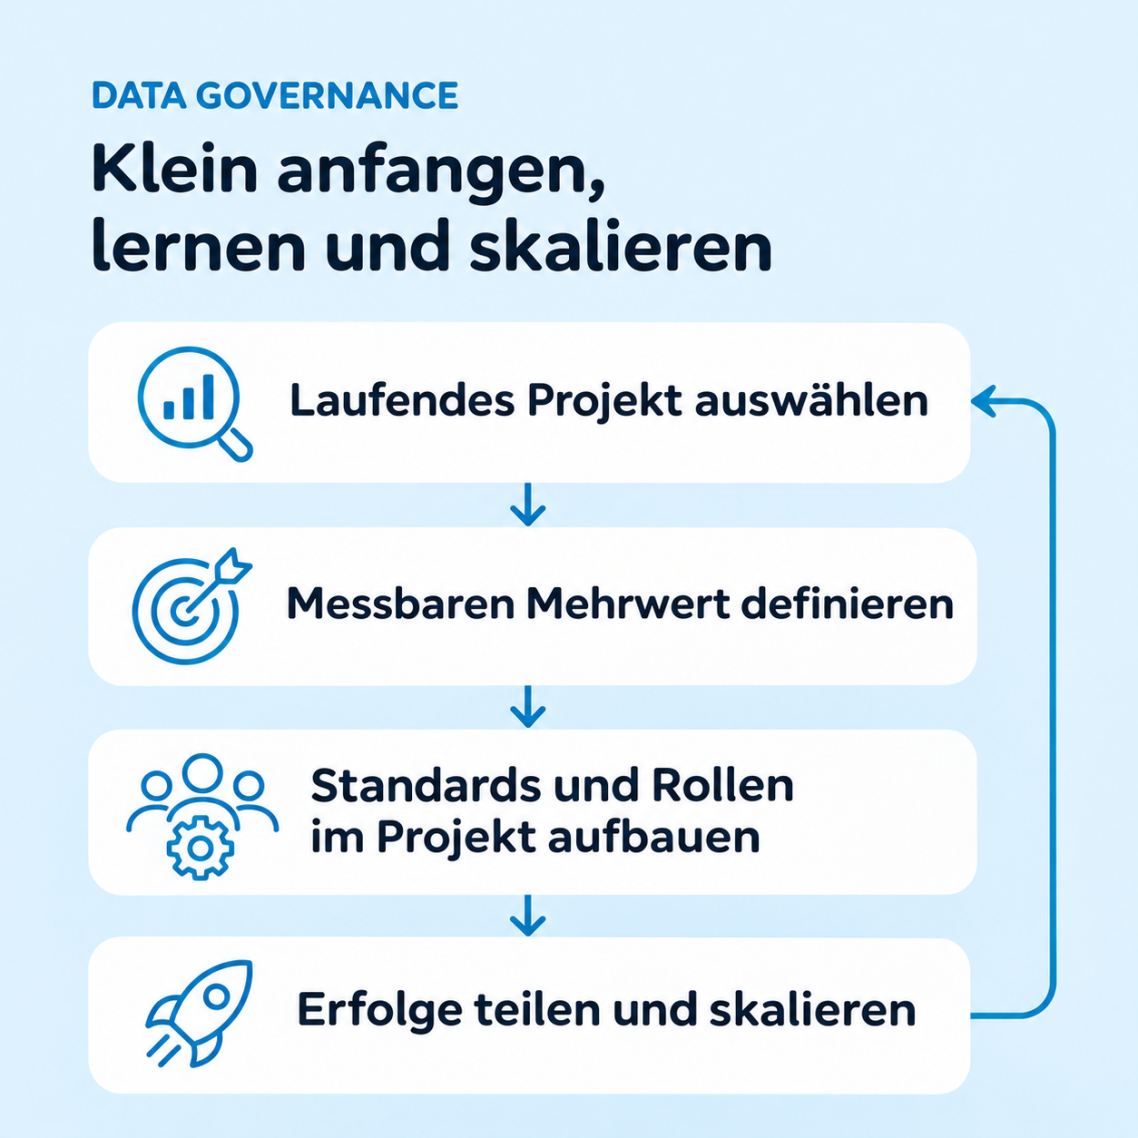
Governance am laufenden Vorhaben statt als Selbstzweck: In Workshops haben wir die Initiativen nach Wirkung und Dringlichkeit bewertet und mit den Kernobjekten Kunde, Lieferant und Material begonnen. Anlegen, Ändern und Sperren wurden als Prozess beschrieben, die Rollen erst dann besetzt, wenn sie gebraucht wurden. Drei Ebenen tragen das Modell: Steering Committee mit dem C-Level, Data Governance Board und Data Stewardship Community in den Divisionen.
Ergebnis: 17 Business Data Stewards und 8 Data Owner, in drei Ebenen bis zum Steering Committee.
PROJEKT 4 · MIGRATION
Daten vor den Prozessen fertig
Ausgangslage
Internationale Unternehmensgruppe, gekoppelte CRM-, MDM- und DMS-Einführung.
Mehrere voneinander abhängige Projekte in unterschiedlichen Phasen, Datenmodelle noch nicht final, kritische Stammdaten unklar. Die Altdaten lagen verstreut in Altsystemen, bei Dritten und in Excel-Listen. Fachliche Data Stewards fehlten.
Ansatz
Zuerst die Systemlandschaft und ihre Verantwortlichen erfasst, dann die fundamentalen Stammdaten bis auf Feldebene bestimmt und Dubletten und inaktive Objekte gemessen. Darauf aufbauend eine Migrationsrichtlinie: welche Daten migriert werden, nach welchen Regeln bereinigt wird, wer bereinigt und abnimmt, wie Deltas gelöst werden. Die Daten werden in drei Zonen aufbereitet (Roh-, Bereinigungs- und Migrationszone), versioniert und mit Rückfallebene.
Ergebnis: Ein Migrationsumfang, der sich auf die notwendigen Daten beschränkt, und klare Verantwortung je Rolle, statt dass Projektmitglieder die Lücke füllen.
Wo stehen Ihre Daten gerade?
30 Minuten, kostenlos und unverbindlich: Sie schildern die Lage, ich sage Ihnen offen, wo ich den größten Hebel sehe.
Oder schreiben Sie mir: isaak.saba@aleph-i.de